7 мин
SLA на техподдержку: метрики, инциденты и контроль
SLA на техподдержку помогает фиксировать ожидания: время реакции и восстановления, приоритеты инцидентов и понятные отчеты для руководства.
Зачем нужен SLA и что ломается без него
SLA на техподдержку нужен в тот момент, когда поддержка перестает быть «помощью по звонку» и становится частью ежедневной работы бизнеса. Он фиксирует, что именно считается услугой поддержки, в какие сроки и с какой ответственностью.
Без SLA почти всегда начинаются одни и те же споры. Когда начинается инцидент: когда пользователь заметил проблему, когда создали заявку или когда ее увидел инженер? А когда инцидент считается закрытым: когда «вроде заработало», когда пользователь подтвердил или когда устранена причина и есть отчет? Если это не записано, каждая сторона считает по-своему. Статистика превращается в спор, а не в управление.
Устные обещания работают, пока заявок мало и все друг друга знают. Потом нагрузка растет: больше пользователей, сервисов, подрядчиков. И фраза «мы обычно отвечаем быстро» уже не помогает. Приоритеты начинают прыгать, важные запросы теряются, а команда выгорает.
Риски для бизнеса понятны и измеримы: простой ключевых систем, срыв сроков, штрафы по контрактам, потери выручки и репутации. Если падает сервис записи пациентов или платежный шлюз, критично не просто «ответить», а восстановить работу в заданное время. Иначе руководству сложно объяснить, почему час простоя превратился в день переписки.
SLA полезен сразу нескольким сторонам. ИТ получает правила приоритизации и планирования ресурсов. Закупки могут сравнивать предложения и контролировать договор. Безопасность понимает, как быстро устраняются уязвимости и как устроены эскалации. Руководство видит риски в цифрах.
Даже если поддержку оказывает интегратор или производитель оборудования (например, при 24/7 сервисе для серверов и рабочих мест), SLA делает ожидания прозрачными и защищает обе стороны от «мы думали, что…».
Термины, чтобы все понимали одинаково
SLA на техподдержку часто проваливается не из-за «плохой поддержки», а из-за разных трактовок одних и тех же слов. Поэтому перед метриками и ответственностью стоит договориться о терминах.
Инцидент и запрос на обслуживание на практике - разные вещи. Инцидент - когда что-то сломалось или работает хуже нормы и это мешает бизнесу (не открывается учетная система, упала сеть, не печатает принтер для документов). Запрос на обслуживание - когда нужно «сделать» или «изменить» (выдать доступ, установить ПО, добавить пользователя, подготовить рабочее место). Если их смешать, получится красивая отчетность и недовольные люди: простые запросы улучшат статистику, а реальные сбои будут тонуть.
Чтобы не спорить о времени, используйте простые определения:
- Время реакции: от момента фиксации обращения до первого осмысленного ответа поддержки (подтверждение, уточняющие вопросы, назначен ответственный).
- Время восстановления: до возврата сервиса в рабочее состояние, даже если временно (обходной путь тоже считается, если он согласован).
- Время решения: до полного устранения причины (замена неисправного оборудования, исправление бага, изменение конфигурации).
Часы поддержки тоже нужно назвать явно: 8x5, 12x6, 24x7. Это меняет не только «когда можно звонить», но и то, как считаются метрики. Например, при SLA 8x5 инцидент в 19:30 может начать отсчет только утром следующего рабочего дня.
Отдельно зафиксируйте точки старта и паузы: когда тикет создан, когда подтвержден, когда взят в работу. Частая практика - считать старт по времени подтверждения (чтобы отсечь обращения без данных) и отдельно прописать, что ожидание ответа клиента останавливает таймер. Пример: пользователь написал «не работает почта», поддержка запросила скрин и данные, а ответ пришел через 3 часа. Эти 3 часа не должны считаться как задержка поддержки, если правило закреплено заранее.
Классификация инцидентов и приоритеты
Классификация инцидентов в SLA нужна, чтобы одинаково понимать, что считать критичным, а что - обычной заявкой. Иначе приоритеты быстро превращаются в «все срочно», а сроки реакции и восстановления теряют смысл.
Приоритет удобнее задавать через влияние на работу и срочность, а не через эмоции. Влияние можно описывать по масштабу (один сотрудник, отдел/филиал, вся организация) и по тому, затронут ли критичный сервис (например, ERP, почта, доступ к серверу, кассы).
Пример шкалы приоритетов
Типовой вариант P1-P4, который легко объяснить и контролировать:
- P1 (критический): простаивает ключевой сервис или инфраструктура, затронута большая часть организации, обходного пути нет.
- P2 (высокий): сильно мешает работе отдела или важной роли, есть временный обходной вариант, но потери заметны.
- P3 (средний): проблема у одного пользователя или небольшой группы, есть обходной путь, работа в целом продолжается.
- P4 (низкий): консультация, настройка, небольшой дефект без влияния на бизнес-процесс, можно запланировать.
Срочность и влияние: не путать
Срочность - это «как быстро нужно», влияние - «сколько и кому мешает». Пользователь может просить «прямо сейчас», но если не работает один принтер при наличии другого, это не P1. Чтобы приоритеты не «завышали», закрепите правило: приоритет назначается по критериям, а не по должности и не по громкости.
Отдельно стоит описать два частых сценария. Первый - повторяющиеся сбои: если одна и та же проблема возникает регулярно, это повод заводить отдельную задачу на устранение причины и отслеживать ее отдельно от разовых инцидентов. Второй - массовый инцидент: много одинаковых обращений объединяются в один мастер-инцидент, чтобы команда не тратила время на дубли и чтобы в отчетах было видно реальный масштаб и время восстановления.
Какие метрики включать в SLA: минимум без лишнего
SLA работает только тогда, когда метрики понятны и их можно проверить по данным. Практичнее взять короткий набор показателей, описать правила расчета и не смешивать инциденты с обычными запросами.
Обычно хватает такого минимума:
- время реакции (подтверждение обращения и первый контакт)
- время восстановления сервиса (включая согласованный обходной путь)
- доступность сервиса за период (месяц или квартал)
- процент соблюдения SLA (доля обращений, выполненных в срок)
- backlog и сроки обработки запросов (если SLA распространяется не только на инциденты)
Время реакции полезно разделить на две части: когда обращение принято в работу (есть номер, ответственный и статус) и когда произошел первый контакт с пользователем или дежурным. Для руководства это индикатор дисциплины, а для пользователей - ощущение, что их не бросили.
Время восстановления - главный показатель для критичных сервисов. Важно заранее зафиксировать, что считается восстановлением: возврат сервиса в рабочее состояние, даже если это временное решение (workaround). Отдельно можно задавать срок на постоянное исправление, но его лучше не путать с восстановлением. Иначе команда будет ждать «идеального решения» и затягивать простой.
Доступность привязывают к окну измерения (чаще месяц) и описывают, что исключается из расчета: плановые работы, согласованные окна обслуживания, внешние провайдеры. Если это не прописать, отчеты будут каждый раз спором о цифрах.
Процент соблюдения SLA тоже нужно формализовать: что значит «в срок», как учитываются ожидание ответа клиента, согласованная пауза, перевод на второй уровень. Простой вариант: «инцидент считается выполненным, если восстановление произошло до дедлайна, а часы ожидания клиента не входят в таймер».
Если SLA покрывает запросы (доступы, установки, консультации), добавьте backlog и целевые сроки выполнения. Иначе инциденты будут закрываться быстро, а очередь «обычных» задач незаметно вырастет и начнет мешать работе.
Пошагово: как сформулировать SLA в договоре или приложении
SLA должен описывать не намерения, а измеримые обещания и условия, при которых они выполняются. Удобно оформлять его как приложение с таблицами: так проще обновлять цифры без переподписания всего договора.
1) Зафиксируйте, что именно поддерживается
Опишите перечень сервисов и границы ответственности: какие системы входят в поддержку, в какие часы, какие каналы приема заявок считаются официальными. Это снимает спорные ситуации, когда «написали в мессенджер» или «проблема на стороне провайдера».
2) Согласуйте классификацию инцидентов и матрицу целей
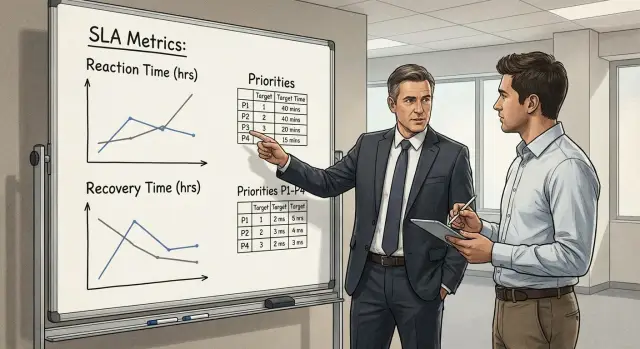
Не делайте 10 уровней. Обычно хватает P1-P4. Дальше добавьте матрицу целевых времен реакции и восстановления (RTO) для каждого приоритета, отдельно для 24/7 и для рабочих часов, если режимы разные.
Пример, как это может выглядеть:
- P1: реакция 15 минут, восстановление 4 часа
- P2: реакция 1 час, восстановление 8 часов
- P3: реакция 4 часа, восстановление 3 рабочих дня
- P4: реакция 1 рабочий день, выполнение по согласованному сроку
Обязательно пропишите, что считается «реакцией» (например, регистрация и первый контакт) и что считается «восстановлением» (возврат сервиса к согласованному уровню).
3) Добавьте исключения и зависимости
Честный SLA содержит условия, когда цели не применяются или пересматриваются: плановые работы, форс-мажор, отсутствие запчастей, зависимость от сторонних вендоров (например, когда нужен ответ производителя или доступ к облачному сервису). Укажите, как такая зависимость фиксируется в тикете и как меняется срок.
4) Опишите обязанности заказчика и правила коммуникации
SLA ломается, если у поддержки нет доступа. Укажите минимальные обязанности заказчика: контактные лица, порядок согласования удаленного доступа, окна для работ, требования к логам и подтверждению простоя.
Для P1-P2 отдельно пропишите коммуникации: кого уведомляют, как часто идут обновления статуса, когда подключается руководство и какие каналы считаются основными.
5) Закрепите критерии закрытия и подтверждение результата
Чтобы «закрыто» не стало формальностью, задайте критерии качества: что именно проверяется, какие показатели должны вернуться в норму, нужен ли отчет о первопричине для P1. Добавьте правило подтверждения: например, заявка закрывается после подтверждения заказчиком или автоматически через N часов при отсутствии ответа, если сервис работает по проверкам.
Процессы контроля: прием, эскалации, ответственность
Даже хорошо прописанный SLA не работает без процесса: как обращение попадает в работу, кто решает спорные случаи и кто отвечает, когда инцидент затрагивает несколько команд.
Единый вход и прием обращений
Сделайте один официальный вход: портал заявок, единая почта или единый номер. Каналов может быть несколько, но все они должны приводить к одной очереди. Иначе метрики «расползутся», а часть запросов потеряется.
На приеме важно фиксировать минимум данных, чтобы потом измерять время реакции и восстановления:
- время регистрации (когда заявка стала видимой поддержке)
- сервис/система и краткое описание влияния
- приоритет и основание (сколько пользователей, есть ли простой)
- контакт ответственного со стороны заказчика
- что считается восстановлением в этом случае (временный обход или полное решение)
Эскалации, смены и ответственность
Эскалация нужна не «когда страшно», а по четким триггерам. Например: прошло больше половины времени до дедлайна по SLA, нет прогресса, нужен доступ, инцидент влияет на критичный сервис. Тогда подключается старший инженер, а при риске срыва сроков - менеджер, который может согласовать приоритеты и привлечь дополнительные ресурсы.
Если требуется 24/7, опишите смены и передачу дежурства: кто принимает незакрытые инциденты, как передает статус и как проверяется, что ничего не «зависло» на стыке. У крупных поставщиков с круглосуточной поддержкой и распределенной сервисной сетью (в том числе у GSE.kz) этот блок обычно оформляют отдельным регламентом.
Чтобы не спорить «кто виноват», используйте RACI в простом виде: Responsible (кто делает), Accountable (кто отвечает за результат), Consulted (кого привлекают), Informed (кого информируют). Для инцидентов с несколькими командами назначайте одного координатора: он ведет таймлайн, фиксирует решения и следит за регулярными обновлениями статуса.
Отчеты для руководства: что показывать и как читать
Отчеты по SLA полезны только тогда, когда по ним можно принять решение. ИТ-команде нужен рабочий, подробный срез раз в неделю. Руководству - короткий ежемесячный обзор без лишних деталей. Один и тот же отчет для всех обычно получается либо слишком сложным, либо слишком поверхностным.
Еженедельный отчет для ИТ лучше строить вокруг конкретных инцидентов: что было самым частым, где были просрочки, почему они случились и какие эскалации сработали. Здесь уместны причины (сбой обновления, ошибка доступа, перегруз ресурса) и действия, которые реально снизят повторы.
Ежемесячный отчет для руководства должен отвечать на вопрос: соблюдаем ли SLA и какой риск для бизнеса. Обычно хватает 5-7 показателей:
- доля инцидентов в SLA (по реакции и по восстановлению отдельно)
- количество критичных инцидентов и их суммарный простой
- среднее и 90-й процентиль времени восстановления
- просрочки: сколько и по каким причинам (ресурс, ожидание пользователя, внешние подрядчики)
- повторные инциденты (одна и та же проблема в течение месяца)
Чтобы отчет читался легко, делайте разрезы по тем зонам, где есть управляемость: по сервисам, подразделениям, типам проблем и по времени суток. Ночные окна и выходные часто подсвечивают слабые места.
Отклонения показывайте короткой карточкой: что случилось, какое было влияние (сервис, пользователи, длительность), почему сроки вышли за рамки и что делаем дальше (дата и владелец). Если, например, два критичных простоя за месяц на одном сервисе связаны с одной причиной, это задача на устранение причины, а не «пожар».
Связка с планом улучшений должна быть прямой: повторяющийся инцидент превращается в конкретную работу (устранить причину, обновить инструкцию, настроить мониторинг), и в следующем отчете видно, стало ли повторов и просрочек меньше.
Пример сценария: SLA для организации с критичными сервисами
Представим организацию на 500 рабочих мест: центральный офис, удаленные филиалы и набор сервисов, без которых работа встает (почта, ERP, сеть, доступ к гос-порталам, телефония, печать для документов). Для таких условий SLA должен быть не про «в среднем», а про четкие правила для самых болезненных сбоев.
Ключевой шаг - заранее договориться о приоритетах и правах. Например, P1 ставится только при остановке критичного сервиса для большого числа сотрудников или при риске потери данных. Чтобы приоритеты не превратились в «все срочно», право ставить P1 получают дежурный админ, руководитель ИТ смены и один представитель бизнеса (например, начальник операционного отдела). Все остальные заявки стартуют как P2-P3 и повышаются после проверки.
Цели можно зафиксировать так: для P1 время реакции - до 15 минут, время восстановления - до 2 часов (как ориентир), с обязательной эскалацией при риске выхода за срок. Важно разделять: «реакция» означает, что инженер принял инцидент и начал действия, а не просто написал «принято».
Коммуникации снимают половину напряжения. Для P1 вводят регулярные статусы каждые 30-60 минут по одному шаблону: что сломалось и кого затронуло, что уже сделано, текущий прогноз, что нужно от бизнеса (доступ, подтверждение, окно работ) и время следующего апдейта.
Закрытие P1 происходит после подтверждения сервиса со стороны владельца процесса (или дежурного в филиале). Затем делается короткий разбор первопричины: несколько строк о том, что произошло, почему, как снизить риск повтора и что изменить в мониторинге или регламентах.
Инструменты, без которых SLA сложно контролировать
Чтобы SLA работал, одних формулировок в договоре мало. Нужны инструменты, которые фиксируют факты: когда инцидент начался, кто принял, что сделали и когда сервис реально восстановился.
Тикет-система: где рождается статистика
Тикет-система нужна не ради удобства, а ради доказуемости. Если обращение можно принять в чате и забыть, SLA превращается в спор «кто и когда писал».
Минимум, который стоит сделать обязательным при создании и закрытии заявки: сервис/система, приоритет и влияние, время регистрации и ключевые отметки (первый ответ, восстановление), статус (в работе, ожидание клиента, эскалация, решено), причина закрытия и краткий итог.
Заранее договоритесь, какие статусы «останавливают часы» (например, ожидание доступа или данных от клиента) и как это отражается в отчетах.
Мониторинг, база знаний и инвентаризация
Автоматические оповещения помогают фиксировать начало инцидента без задержек. Для критичных сервисов лучше, когда инцидент создается из мониторинга автоматически, а не после звонка. Это особенно заметно в инфраструктуре с серверами и рабочими местами, где сбой может случиться ночью или в выходные.
База знаний ускоряет восстановление: типовые сбои, проверочные шаги, шаблоны сообщений пользователям. При повторяющихся задачах (обновления, доступы, замены оборудования) статьи дают более стабильное время решения и уменьшают зависимость от «ключевых людей».
Инвентаризация (каталог сервисов и владельцев) спасает в момент аварии: кто отвечает за сервис, где он размещен, какие контакты для эскалации, какие окна изменений допустимы.
Чтобы отчеты по SLA не расходились, нужен «единый источник правды»: одна тикет-система для учета, единые правила времени (часовой пояс, рабочие часы) и одно место, где собираются события мониторинга и данные по заявкам. Тогда руководству показывают не мнения, а измеримые факты.
Частые ошибки и как их избежать
Самые болезненные проблемы в SLA начинаются не из-за «плохой поддержки», а из-за неточных слов. Когда формулировки расплывчатые, каждая сторона читает их по-своему, и спор становится вопросом интерпретации.
Вот типовые промахи и как их закрыть:
- Обещания вроде «оперативно» или «по мере возможности». Заменяйте их конкретикой: время реакции, время восстановления, часы обслуживания и официальный канал обращения.
- Не определено, что считается восстановлением. Разделите понятия: временное восстановление работоспособности (обходное решение) и полное устранение причины (устойчивое исправление) с отдельными целями.
- Смешали инциденты и запросы в одной таблице без правил. Разведите их: инцидент - сбой, запрос - изменение/доступ/консультация. Для запросов обычно нужны другие метрики, а не RTO.
- Нет исключений и обязанностей заказчика. Пропишите, что останавливает таймер (ожидание доступа, согласования, данных) и что заказчик обязан предоставить (контакты, удаленный доступ, логи, перечень критичных сервисов).
- Отчеты «для галочки». Сделайте их управленческими: причины нарушений, повторяющиеся инциденты, топ узких мест и меры на следующий месяц.
Если вы видите в отчете «99% выполнено», задайте один проверочный вопрос: какие 1% были провалены и что изменилось, чтобы это не повторилось.
Короткий чек-лист и следующие шаги
Чтобы SLA реально работал, начните не с красивых цифр, а с понятной базы: что поддерживается, насколько это важно и как вы узнаете, что договоренности выполняются.
Если на любой пункт ответ «пока нет», это и есть план работ на ближайшие 2-4 недели:
- Есть каталог сервисов (конкретно: почта, ERP/1С, сеть филиалов, рабочие места) и отмечено, что критично для бизнеса.
- Определена матрица приоритетов: признаки P1/P2/P3 и целевые времена реакции и восстановления для каждого уровня.
- Настроен единый вход для обращений и описаны правила эскалации: когда подключается дежурный, руководитель смены, вендор.
- Согласован формат отчетов: какие метрики показываем, как часто, и кто владелец каждого показателя со стороны заказчика и исполнителя.
- Запланирован пилот: выбраны 1-2 самых важных сервиса, SLA прожит на них 4-6 недель, затем цели скорректированы по фактическим данным.
Практичный следующий шаг - зафиксировать решения в одном документе на 1-2 страницы и провести короткую встречу с теми, кто будет работать по этим правилам: служба поддержки, ИТ-руководитель, владельцы сервисов.
Если не хватает ресурсов на процессы, дежурство или инфраструктуру (мониторинг, учет заявок, запасные части), можно подключить интегратора с опытом 24/7 поддержки. В Казахстане такие задачи часто закрывают команды уровня GSE.kz: когда системная интеграция, поддержка и поставка оборудования идут вместе, проще быстрее восстанавливать критичные сервисы и держать SLA в контроле.
Частые вопросы
Зачем вообще нужен SLA на техподдержку, если «и так помогаем»?
SLA нужен, когда поддержка становится частью ежедневной работы: он фиксирует **что именно поддерживается**, **в какие сроки** и **как измеряются результаты**. Без SLA начинаются споры о старте/финише инцидента, «все срочно», теряются приоритеты и сложно объяснить бизнесу, почему простой затянулся.
С чего начинаются типовые конфликты по SLA и как их предотвратить?
Самое частое — разная трактовка времени. Заранее закрепите в SLA: - когда начинается отсчет (создание тикета или подтверждение данных); - что считается «реакцией» (не автоответ, а первый осмысленный контакт); - что считается «восстановлением» (временный обходной путь тоже, если согласован); - какие статусы **останавливают таймер** (ожидание доступа/ответа заказчика).
Чем отличается инцидент от запроса на обслуживание и почему это важно для SLA?
По умолчанию разделяйте так: - **Инцидент** — что-то сломалось/ухудшилось и мешает бизнесу. - **Запрос на обслуживание** — нужно сделать/изменить (доступ, установка, настройка). Если смешать, отчеты будут «красивыми», а реальные сбои будут тонуть среди простых задач. В SLA лучше иметь отдельные цели и метрики для инцидентов и запросов.
Какие термины обязательно определить в SLA, чтобы все считали одинаково?
Минимально зафиксируйте три определения: - **Время реакции** — от фиксации обращения до первого осмысленного ответа. - **Время восстановления** — до возврата сервиса в рабочее состояние (включая согласованный workaround). - **Время решения** — до устранения причины. Для критичных сервисов главным обычно является **восстановление**, а «решение причины» можно вести отдельной задачей.
Как правильно прописать часы поддержки (8x5/24x7) и как это влияет на SLA?
Укажите явно: 8x5, 12x6 или 24x7 — и как считаются метрики в каждом режиме. Если поддержка 8x5, то инцидент, пришедший вечером, может начать отсчет только утром следующего рабочего дня — это должно быть прописано, иначе будет ощущение «игры с цифрами».
Как настроить приоритеты, чтобы не получилось «все срочно»?
Рабочий вариант — шкала **P1–P4** по влиянию и срочности: - P1: простой критичного сервиса, нет обхода, затронуты многие. - P2: сильно мешает отделу/важной роли, обход есть, но потери заметны. - P3: проблема у 1–нескольких пользователей, работа в целом идет. - P4: консультации/плановые мелочи. Зафиксируйте правило: приоритет назначается по критериям, а не «по громкости» или должности.
Какие метрики включить в SLA, чтобы было полезно, но без лишней бюрократии?
Практичный минимум: - время реакции; - время восстановления; - процент соблюдения SLA (по реакции и восстановлению отдельно); - доступность сервиса за период (если измеряете); - backlog и сроки выполнения запросов (если SLA покрывает не только инциденты). Важно: формально описать расчет (что исключается, какие паузы возможны), иначе цифры будут предметом спора.
Как выглядит нормальная матрица SLA по P1–P4 (пример)?
Дайте одну простую таблицу целей по приоритетам и отдельно подпишите определения. Типовой пример: - P1: реакция 15 минут, восстановление 4 часа - P2: реакция 1 час, восстановление 8 часов - P3: реакция 4 часа, восстановление 3 рабочих дня - P4: реакция 1 рабочий день, выполнение по согласованному сроку И обязательно: что считается «реакцией», что — «восстановлением», и когда таймер ставится на паузу.
Какие правила эскалации и ответственности стоит прописать, чтобы SLA реально выполнялся?
Закрепите **правила эскалации** по триггерам, например: - прошло больше половины времени до дедлайна, а прогресса нет; - нужен доступ/данные от заказчика; - инцидент затрагивает критичный сервис. Назначайте одного координатора на мультикомандные инциденты и договоритесь о регулярности статус-обновлений для P1–P2. Для 24/7 отдельно опишите смены и передачу дежурства.
Какие инструменты нужны, чтобы SLA можно было контролировать, а не спорить о нем?
Минимально нужен «единый источник правды»: - тикет-система (время регистрации, первый контакт, восстановление, статусы, причина закрытия); - мониторинг для критичных сервисов (желательно автоматическое создание инцидентов); - база знаний для типовых действий; - инвентаризация/каталог сервисов и владельцев. Если поддержка и сервисная сеть работают 24/7 (например, как у интеграторов и производителей уровня GSE.kz), дисциплина учета и мониторинг особенно важны: иначе ночные инциденты просто не будут фиксироваться корректно.